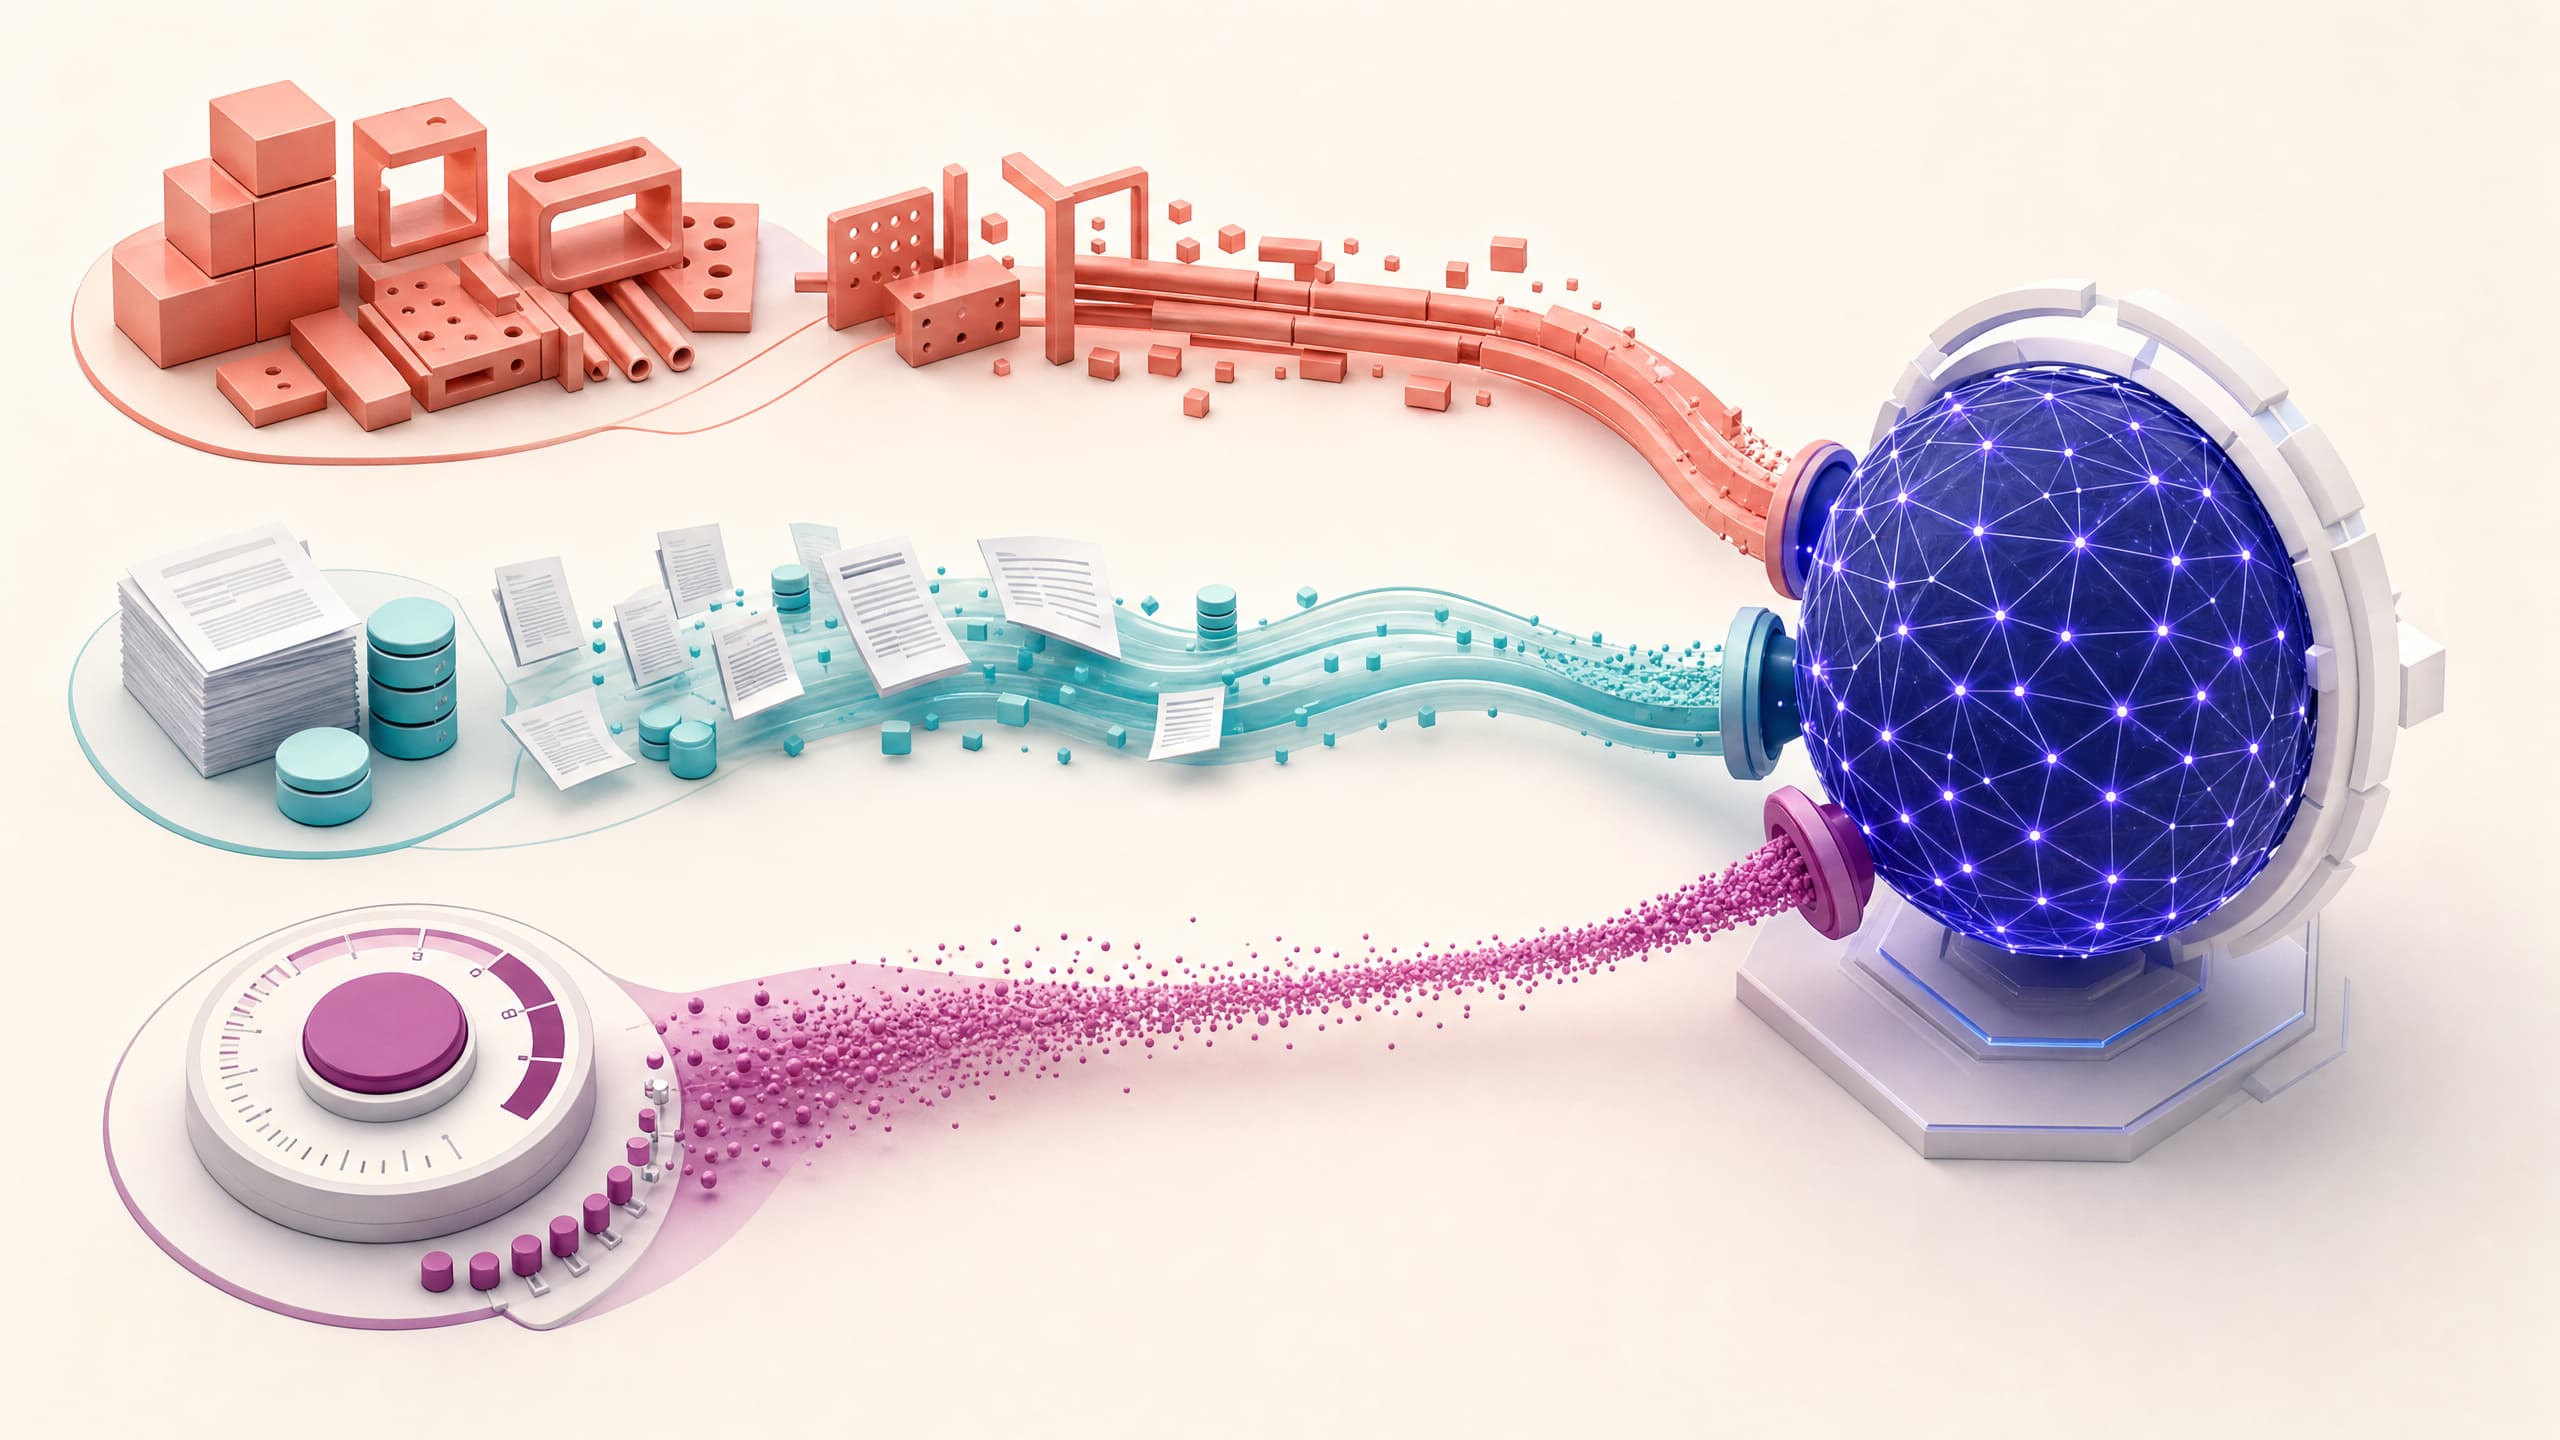
Die Frage, die wirklich bestimmt, wie sich ein KI-Produkt verhält, ist nicht „welches Modell?" Sondern: „Wo lebt die Arbeit?" Jedes brauchbare Applied-AI-System ist ein Stapel von Schichten, und das Modell ist nur eine davon. Die Schichten sind: der Prompt, der Kontext, den Du abrufst, die gelernten Gewichte des Modells und das Gerüst, das Du selbst darum herum schreibst — Tool-Aufrufe, Validierung, Retry-Logik, Eskalation. Jedes Team trifft diese Allokationsentscheidung früh, die meisten mit dem Bauch, und fast niemand überarbeitet sie nach dem ersten Quartal.
Die vier Orte, an denen die Arbeit leben kann
- Im Prompt. Selten die Antwort, immer die Baseline. Wenn es mit einem sauberen Prompt plus ein paar Beispielen funktioniert, starte hier. Das ist die einzige Schicht, die Dich nichts kostet außer einer Textdatei, und die mit einem Deploy änderbar ist.
- Im abgerufenen Kontext. Das Wissen, das sich ändert — Doku, Richtlinien, Tickets, Daten — sollte in einer Retrieval-Schicht leben, nicht im Modell. Dafür ist RAG da: Das Modell bleibt generisch, die Fakten bleiben aktuell, und ein Dokument-Update ist ein Produkt-Update.
- In den Gewichten. Verhaltensstil — Format, Ton, Domain-Jargon, die Form des Outputs, die Dein Geschäft braucht — lässt sich per Fine-Tuning ins Modell verschieben. Das ist die teuerste Schicht und die langsamste. Nutze sie nur für die zweite Ordnung, die weder Prompt noch Kontext tragen können.
- In Deinem Gerüst. Validierung, Tools, Fallbacks, Eskalationspfade, menschliche Review-Gates. Das ist die einzige Schicht, die Du vollständig kontrollierst — und jene, in die fast jedes unreife Team am wenigsten investiert. Das Modell, das Du aufrufst, ist ersetzbar; die Maschinerie drumherum ist Dein Produkt.
Die Routing-Regeln
Der praktische Algorithmus, den ich mit Teams nutze: Schiebe die Arbeit so weit wie möglich nach unten im Stack — mit Belegen auf jeder Stufe.
Starte mit dem Prompt und einem Golden Set. Miss, wo es scheitert. Hängen die Fehler mit Wissen zusammen — Fakten, aktuelle Informationen, firmenspezifische Details —, ist die Lücke ein Retrieval-Problem: Kontext ergänzen, Chunking fixen, Ranking verbessern, neu messen. Hängen die Fehler mit Form zusammen — der Output sieht nicht so aus oder benimmt sich nicht so, wie die Domain es verlangt —, ist die Lücke ein Stilproblem, und Stil ist genau das, was Fine-Tuning wirklich gut behebt. Und wenn die Fehler mit Schritten zusammenhängen — die Aufgabe verlangt mehrere Aktionen in Folge, Tool-Nutzung, Reaktion auf Zwischenergebnisse —, ist das ein Scaffolding-Problem, und keine Modellarbeit der Welt behebt es.
Drei Regeln halten das ehrlich:
- Die Datenlage entscheidet über Fine-Tuning. Fine-Tuning ist bei Tatsachen eine Fiktion („unsere Preisseite wurde aktualisiert"); es ist eine behauptete Fähigkeit („produziere konstant rechtskonforme Verträge") und braucht einen Datensatz, der die Behauptung belegt. Wer fünfzig Beispiele hat, hat einen Prompt, keinen Trainingssatz.
- Die Veränderlichkeit entscheidet über RAG. Ändert sich das Wissen monatlich — Produktdoku, Policy-Updates, neue Preise —, muss es außerhalb des Modells leben. In dem Moment, in dem Du Fakten in Gewichte feintunest, wird jede Faktenänderung zum Retraining-Projekt mit einer Daten-Pipeline, die Du nicht hast.
- Das Fehlerbudget entscheidet über Scaffolding. Die Frage ist nie „kann das Modell das?" Sondern: „Was passiert, wenn es scheitert — und wie billig ist das Scheitern?" Scaffolding ist der Ort, an dem Du ausgibst, um Scheitern billig zu machen: Validierung, menschliches Review, Eskalationspfade. Wenn Du Dir das Scheitern noch nicht leisten kannst, kannst Du Dir das Automatisieren noch nicht leisten.
Warum die Bauch-Entscheidung meist die teure ist
Das Muster, das ich am häufigsten sehe, läuft gegen die Mathematik. Ein Team bekommt eine beeindruckende RAG-Demo, investiert also wochenlang in Embeddings und Chunking — nur um festzustellen, dass sein Problem nie faktisches Abrufen war, sondern dass das Output-Format nicht zum System der Kunden passte. Oder ein Founder feintunet ein Modell, weil Fine-Tuning nach „echter KI" klingt — und muss es bei jeder Angebotsänderung neu trainieren. Die teuren Orte werden zuerst gewählt, die billigen nie probiert.
Dass das Modell selbst jedes Quartal überlebt, liegt daran, dass es der billigste Teil des Stacks ist, den man verbessert: einwechseln, Golden Set neu laufen lassen. Die Schichten, die sich vermehren, sind jene, die Du ohne Training-Job iterieren kannst: ein schärferer Prompt, ein besseres Retrieval, Validierungscode, der den Fehlermodus abfängt, den Dein Golden Set gefunden hat.
Das Modell ist eine Abhängigkeit, keine Strategie
Es gibt eine Version dieses Arguments, die noch tiefer geht: Das Modell, das Du heute auswählst, ist ein Commodity, der sich vierteljährlich ändert — und die Architektur, die überlebt, ist die, in der das Modell eine austauschbare Komponente hinter einem Vertrag ist. Wo die Arbeit lebt, ist die Strategie. So zu tun, als sei das Modell die Strategie, ist nur ein langsamerer Weg, die Strategie zu bezahlen, die Du nie entworfen hast.
Alloziere die Arbeit wie ein Budget: an die Schicht mit dem besten Beleg-Kosten-Verhältnis, ein Experiment nach dem anderen, gemessen gegen dasselbe Golden Set. Das ist nicht weniger aufregend, als Modell-Optionen zu erwägen. Es ist nur die Version, die ein Produkt ergibt.